Een AI-model dat een paar vragen goed beantwoordt is inmiddels gewoon. Waar het nu om draait, is werk dat uren of dagen duurt: een codebase omzetten, een audit draaien, een complete app bouwen zonder dat je er steeds naast moet zitten. Op 9 november 2026 bracht Anthropic daarvoor Claude Fable 5.2 uit, samen met zusje Claude Mythos 5.2.
In deze blogpost lees je wat er nieuw is, wat Anthropic en vroege gebruikers er in de eerste dagen mee hebben gedaan, wat het kost en wanneer je het wel en niet inzet.
Wat is er veranderd?
Fable is het model waar Anthropic naar verwijst voor het zwaarste werk, een stap boven Opus. Versie 5.2 volgt Fable 5.1 op en brengt vooral dit:
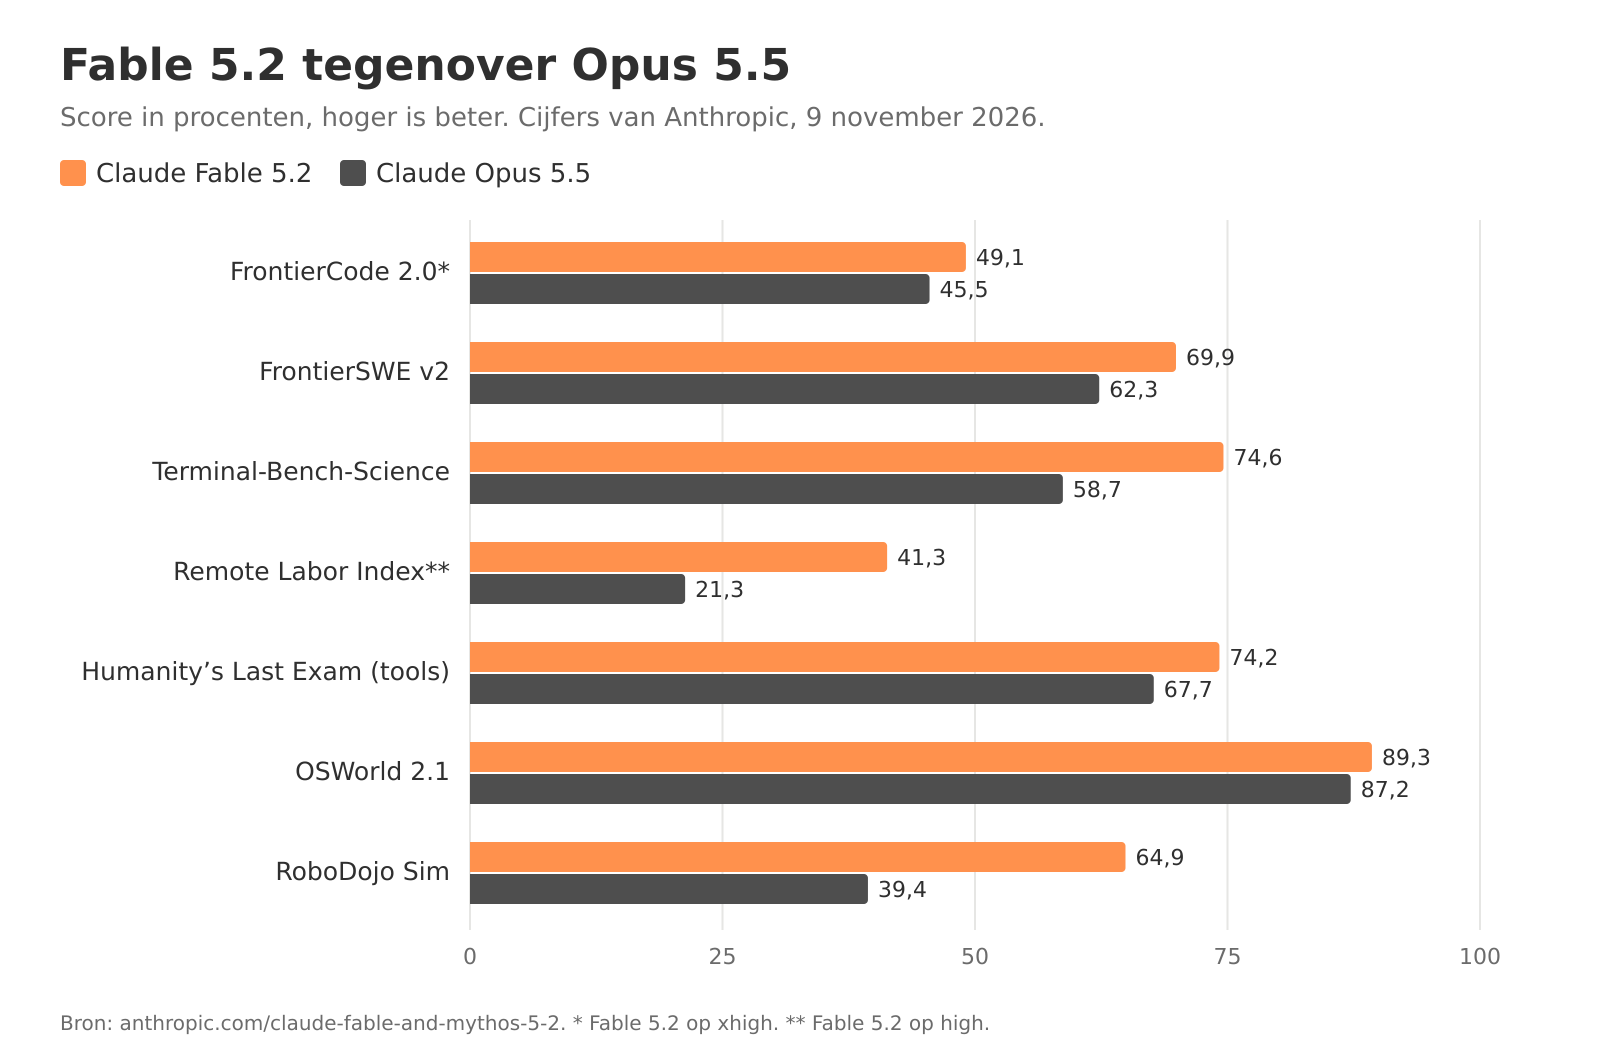
Beter in code, redeneren en beeld. Anthropic meldt vooruitgang op alle drie.
Tot 30% snellere uitvoer dan Fable 5.1, en testers zeggen dat het model duidelijker communiceert.
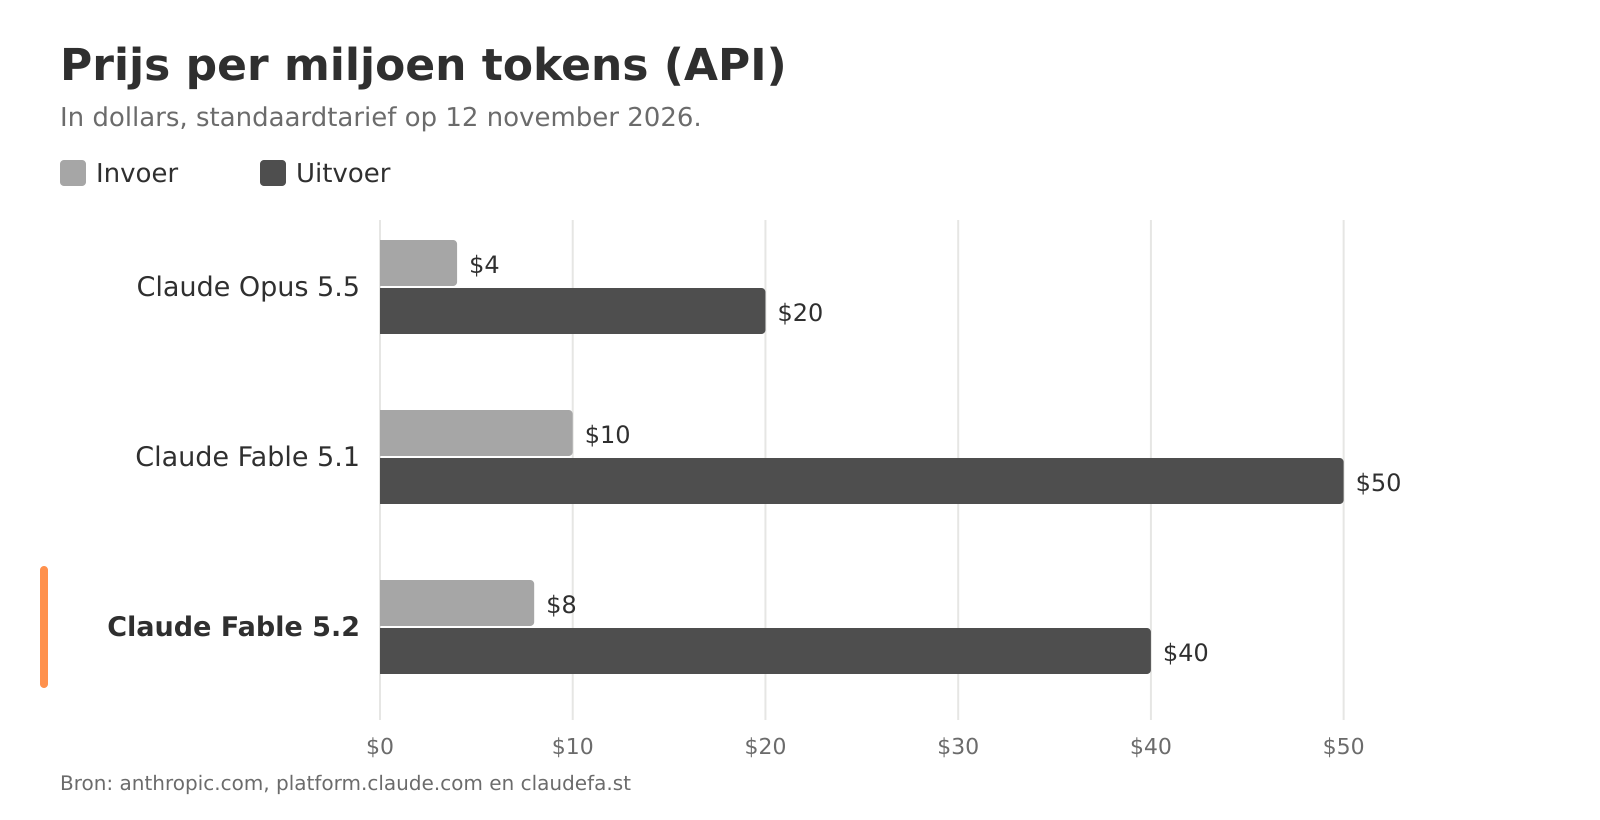
Lagere prijs. Via de API kost Fable 5.2 $8 per miljoen invoertokens en $40 per miljoen uitvoertokens, tegen $10 en $50 voor Fable 5.1. Er is ook een snelle modus tot 2,5 keer sneller, voor $16 en $80.
Dirigent van andere modellen. Fable 5.2 kan als Advisor dienen, waarbij kleinere modellen het raadplegen bij lastige problemen, of als Orchestrator eenvoudige taken overlaten aan kleinere modellen.
Groot geheugen. Een contextvenster van 1 miljoen tokens en tot 128.000 tokens uitvoer per antwoord. Het model denkt altijd adaptief na; met de effort-instelling (van low tot max) bepaal je hoeveel.
Claude Mythos 5.2 is hetzelfde onderliggende model, met ruimere grenzen voor cybersecurity en biologie. Rechtstreeks is dat alleen beschikbaar voor organisaties die Anthropic via zijn Cyber- of Life Sciences-verificatieprogramma heeft goedgekeurd; Claude Enterprise-klanten krijgen het ook via Claude Security. Fable 5.2 is breed beschikbaar: in de Claude-apps (afhankelijk van je abonnement), in Claude Code en via de API op het eigen platform van Anthropic, Amazon Bedrock, Google Cloud en Microsoft Foundry.
Fable 5.2 wint niet alles. In Anthropics eigen tabel scoort Gemini 4 Carbon hoger op AutomationBench en houdt Opus 5.5 een hogere Elo-score op AA-Briefcase. De FrontierCode-score in de grafiek is die van Fable op de xhigh-stand. Opvallend is wel de prijs per taak: op de high-stand haalt Fable 5.2 op FrontierCode ongeveer de beste score van Opus 5.5, voor ongeveer de helft van de kosten per taak.
Wat Anthropic er zelf mee liet doen
De voorbeelden uit de aankondiging laten zien waar dit model voor bedoeld is: lang, groot en zelfstandig werk.
Een besturingssysteem vanaf nul. Een engineer liet Fable 5.2 acht dagen lang meer dan 1.000 subagents aansturen. Uit een lege map kwam een OS dat opstart op een laptop, met drivers, bestandsopslag, vensters, een inlogscherm en een installer.
Een migratie naar Rust. Agents met een vroege versie van het model zetten een kritieke productiedienst om van Python naar Rust. Die dienst start nu ongeveer 26 keer sneller.
Drie werkende apparaten. Vanuit één alinea tekst ontwierp Claude, samen met printplatenmaker Diode, een spraakassistent-hub, een USB-speakerphone en een handheld virtueel huisdier: printplaat, 3D-geprinte behuizing en software. Alle drie werkten zonder elektrische aanpassingen.
Wiskunde in 30 uur. Een team van 1.000 Fable 5.2-agents formaliseerde de laatste stelling van Fermat in Lean in ongeveer 30 uur, met onder meer 47 bewezen lemma’s uit de eerste poging als startpunt. Die eerste formalisering duurde 11 dagen.
Natuurkunde en robots. Het model loste twee open problemen op over zwarte gaten en kwantumzwaartekracht, en bestuurde robots bij taken als een puzzelkubus oplossen en een dop van een fles draaien.
Wat klanten melden
Bedrijven die vooraf toegang hadden, beschrijven vooral minder bijsturen en betrouwbaarder werk:
Vercel zag projecten in dagen in plaats van weken af komen, zonder dat het model telkens gecorrigeerd moest worden en met minder commentaar van de reviewers.
Uber draaide een security-audit van 10 tot 12 uur met zo’n 170 reviewer-agents.
Oracle kreeg bij een test met zakelijke SQL de juiste uitkomst, waar twee andere modellen waarden verkeerd optelden en 5 tot 8 keer te hoog uitkwamen.
Box zag het model een tegenstrijdigheid opmerken in een leningaanvraag: salarisstortingen die niet klopten met het banksaldo.
Cognition merkt dat het model zegt wanneer het iets niet weet, in plaats van iets te verzinnen.
Wat mensen er nu al mee bouwen
Buiten Anthropic verschijnen de eerste verhalen van makers die hun eigen project beschrijven, naast een overzicht van MindStudio met demo’s van testers. Een deel van hen kon het model al voor de release gebruiken.
Een game voor een neefje, grotendeels in één nacht.Lex Toumbourou had in juni een eerste versie gemaakt van een beat ’em up naar de tekeningen van zijn neefje, met twaalf eindbazen en een puppy die gered moet worden. Op 10 november beschreef hij hoe hij Fable 5.2 in Claude Code voor het slapengaan één uitgebreide prompt gaf om het spel af te maken en het zo leuk mogelijk te maken. In die nacht herschreef het model het grootste deel van de code en liet het via beeld- en audiodiensten ongeveer 175 afbeeldingen en 140 geluidsfragmenten maken. Het spel kreeg cutscenes, een einde en co-op voor vier spelers met controllers; na het testen met de familie kwamen er speelbare familieleden bij. Een bot die het model zelf schreef, speelde alle twaalf levels in een browser na en controleerde de schermafbeeldingen. Over twee dagen en zo’n 600 verzoeken kwam het totaal voor Claude op ongeveer 340 miljoen tokens, het grootste deel uit de cache.
Honderden werelden uit één alinea. Ethan Mollick, die het model voor de release kon gebruiken, beschrijft hoe hij begon met één alinea en agents liet doorbouwen, met af en toe bijsturing. Na 20 uur stonden er 204 werelden, later meer dan 450, allemaal live in code getekend. Hij is ook kritisch: de kwaliteit was wisselend, en in zijn projecten merkten de agents niet zelf op wanneer hun werk te lang, herhalend of saai was.
Een dashboard in vijf minuten. Griffin Wooldridge liet op 9 november in Claude Code een financieel dashboard bouwen in ongeveer vijf minuten en een landingspagina in ongeveer twaalf; die laatste opdracht liep in twee sessies tegelijk, elk met een eigen stijl. Het model bekeek zijn pagina’s zelf in een browser en herstelde een deel van wat niet klopte. Eén van de twee landingspagina’s bevatte wel verzonnen cijfers, die je voor publicatie moet vervangen.
Grote demo’s van testers. Volgens een overzicht van MindStudio bouwden testers elk vanuit één prompt een spreadsheet-app in de browser met formules en draaitabellen (ongeveer 50 uur bouwtijd), een videobewerker voor Windows met een tijdlijn en keyframes, en een multiplayer partygame met tien levels.
Kleine, betaalbare projecten. Dezelfde testers maakten ook een natuurkundige simulatie van een kogel door een waterballon (rond de $91 aan API-kosten) en een optimalisatietool voor 3D-printbare torens (rond de $37).
💡 De grote games en app-klonen zijn vooral een demonstratie van wat kan, met miljarden tokens en duizenden dollars aan API-kosten. Testers noemen Fable 5.2 zelf een solide, stapsgewijze verbetering ten opzichte van Opus 5.5. Het indrukwekkende zit vooral in hoe lang het zelfstandig doorwerkt.
📚 Zelf kijken? Het spel van Lex Toumbourou is in de browser te spelen, en zijn blog laat de tekeningen van zijn neefje naast de spelfiguren zien. Mollick en Wooldridge tonen in hun stukken schermafbeeldingen van hun resultaten.
Wat kost het?
Fable 5.2 is goedkoper dan zijn voorganger, maar per token nog steeds twee keer zo duur als Opus 5.5. Anthropic raadt zelf aan om dagelijks werk met Opus 5.5 te beginnen en pas naar Fable te gaan voor de lastigste taken, of juist omlaag naar Sonnet 5.5 of Haiku 5.5 voor eenvoudig werk.
Wanneer kies je Fable 5.2?
Kies Fable 5.2 voor werk met veel stappen, veel context en ruimte voor eigen oordeel:
een grote codebase ombouwen of migreren;
een audit of review waarbij veel agents tegelijk werken;
een volledige app, tool of game bouwen vanuit een duidelijke beschrijving;
onderzoek waarbij het model zelf moet bepalen wat de volgende vraag is.
Voor een snelle vraag, een kort script of een mail is Opus 5.5 per token de helft goedkoper. Binnen een grote klus kan Fable als Orchestrator eenvoudige deeltaken zelf aan kleinere modellen overlaten.
Tot slot
Fable 5.2 is geen nieuw soort AI, maar wel een model dat sneller en goedkoper is dan zijn voorganger en gemaakt is voor lang, zelfstandig werk. Dat zie je terug in wat ermee gebouwd wordt: van een besturingssysteem tot een spel voor een neefje. Wil je het zelf proberen, begin dan met één klus die je normaal aan een collega voor een paar dagen zou geven.
Met één Cloud Policy-instelling voegt Microsoft 365 een zichtbaar of hoorbaar watermerk toe aan AI-video en -audio. Zo zet je het aan en hier stopt het.